外来で研修医が「ChatGPTに聞いたら、この鑑別が出ました」と言ってきたとき、指導医は何と返せばよいのでしょうか。禁止するのは簡単ですが、原著が勧めているのは逆です。研修医がAIの鑑別を持ってきたその瞬間こそ、臨床推論とAIリテラシーを同時に鍛えられる教育機会だと位置づけ、そこで何を聞くかを構造化したのが、NEJM 2025 が提唱したDEFT-AIアプローチです1。そして日本語の解説で見落とされがちな点があります——DEFT-AI の頭文字はD・E・F・Tの4文字ですが、ステップは5つあるということです。本記事では、なぜこの枠組みが必要なのかを一次文献の数値で示したうえで、5つのステップと明日から使える問いかけを、原著本文の逐語とともに整理します。指導医・研修医・医学生向けです。
📊 動画を見る時間がない方へ ― スライド資料をご用意しています
本動画で使用した全21枚のスライドを、Web上で閲覧またはPDFでダウンロードできます。
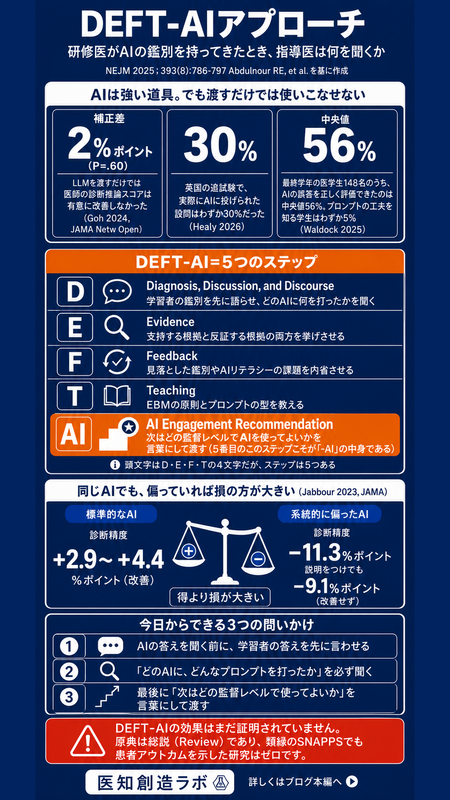
※ 画像をクリックすると原寸大で表示できます
- ステップは5つ:原著のKEY POINTSは DEFT-AI (diagnosis, evidence, feedback, teaching, and recommendation for AI use) と逐語で書いている。頭文字はD・E・F・Tの4文字だが、5番目「AI Engagement Recommendation」こそがAI時代に足された本体1。
- AIを渡すだけでは診断推論は良くならない:無作為化比較試験で補正差は2パーセントポイント(95%CI −4〜8、P=.60)。一方でLLM単独は従来資源群より16パーセントポイント高い2。道具ではなく使い方の問題。
- 間違ったAIのときに大きく損をする:標準的なAIでは+2.9〜+4.4パーセントポイントだが、系統的に偏ったAIでは−11.3パーセントポイント、説明をつけても−9.1パーセントポイントで改善しない4。
- 検証は自動的には起きない:最終学年の医学生148名がLLM出力を正しく評価できたのは中央値56%、clinical prompt engineering を知っていたのは5%6。
- 合言葉は "verify and trust":原著は「信じてから検証する」ではなく検証してから信じると語順を定めている1。
- ただし効果は未証明:原典は総説であり、DEFT-AIの有効性を示した研究は確認できていない。煽らずに使う。
目次
- 1. 研修医がAIの答えを持ってくる時代に、指導医が直面する問題
- 2. まず数字を見る ― AIを渡すだけでは診断推論は良くならない
- 3. しかも「AIが間違っているとき」に大きく損をする
- 4. 検証は自動的には起きない ― 正しく評価できたのは中央値56%
- 5. deskilling は本当に起きるのか ― 大腸内視鏡の実データと、その限界
- 6. DEFT-AIアプローチとは ― 頭文字は4文字、ステップは5つ
- 7. 5番目のステップ「AI Engagement Recommendation」が本体
- 8. ステップ別・明日から使える問いかけ集
- 9. centaur と cyborg ― タスクのリスクで使い分ける
- 10. DEFT-AIは新発明ではない ― Neher 1992 → Savaria 2022 → 2025
- 11. "verify and trust" ― 検証してから信じる
- 12. この枠組みの限界 ― まだ効果は証明されていない
- まとめ ― 指導医が明日から変えられる3点
- よくある質問(FAQ)
- 参考文献
1. 研修医がAIの答えを持ってくる時代に、指導医が直面する問題
NEJM 2025 の総説は、次の場面から始まります。原著が「fictitious but realistic example(架空だが現実的な例)」と明示している架空の症例です1。
この場面が難しいのは、指導医のほうがAIに不慣れであることが珍しくないからです。原著も「指導医は、学習者のほうが自分より使いこなしているかもしれない技術の利用を監督する立場に置かれる」と率直に書き、だからこそ「学習者主導の気づきの瞬間を歓迎し、AIの能力と限界について共同で探究することを促すべきだ」と述べます。原著の言葉では "In this new terrain, teachers are learners, too."(この新しい地形では、教える側もまた学習者である)です1。
何を心配しているのか ― 4つの言葉の整理
AIへの認知的負荷の外部化(cognitive off-loading)は、それ自体が悪ではありません。原著は「定型作業をAIに任せてワーキングメモリの負荷を下げることは、より要求の高い課題に頭を使うための方策になる」と明言しています。問題は臨床推論や意思決定のような複雑な課題まで外部化したときで、原著は次の4語で整理しています(この整理の出典は原著の参考文献9番)1,13。
| 用語(原文) | 原著の定義(逐語) | 日本語 |
|---|---|---|
| automation bias | overreliance on automated systems and risk of error | 自動化システムへの過度の依存と、それに伴う誤りのリスク |
| deskilling | loss of previously acquired skills | いったん獲得した技能の喪失 |
| never-skilling | failure to develop essential competencies | そもそも必須能力が育たないこと |
| mis-skilling | reinforcement of incorrect behavior due to AI errors or bias | AIの誤りや偏りによって誤った行動が強化されること |
このうち研修医世代に固有なのが never-skilling です。LLMへの信頼をめぐる視点論文は「重要な作業をLLMに頻繁に依存することは医療者の診断力・思考力の低下を招きうる。とりわけ将来の専門職の育成と成長に影響する」と述べています12(ただしこの論文自身が理論的考察であり実証データではないと留保しています)。すでに技能を持つ指導医より、これから獲得する研修医のほうが失うものが大きい——だから指導医が介入する意味があります。
2. まず数字を見る ― AIを渡すだけでは診断推論は良くならない
「良いAIを使わせれば診断推論も伸びるはずだ」という直感は、無作為化比較試験で支持されませんでした。米国の医師50名(指導医26名・研修医24名)を対象とした単盲検RCTでは、診断推論スコアの中央値はLLM群76%(IQR 66-87)対 従来資源のみ群74%(IQR 63-84)、補正差2パーセントポイント(95%CI −4〜8、P=.60)で有意差はありませんでした。所要時間も519秒対565秒(差 −82秒、P=.20)と変わりません2。
ところが同じ研究で、LLM単独の成績は従来資源群より16パーセントポイント高い(95%CI 2〜30、P=.03)のです2。道具は強い。強い道具を渡された人間の成績が上がらない。問題は性能ではなく、渡し方と使い方にあります。
この解釈を裏づけるのが英国でのレプリケーションです。英国医師22名の被験者内比較では、LLMへのアクセスがあると成績は改善しました(74.3%対65.7%、p=0.001)が、LLM補助あり群はなおLLM単独より21.3パーセントポイント低く(p<0.001)、改善幅のばらつきも大きい(SD 12.8%)。そして決定的なのは、症例設問のうち実際にLLMに投げられたのは30%だけだったことです。著者らは「human-AI collaboration の潜在能力を引き出すには、これらのツールを認知ワークフローに統合する訓練に焦点を当てる必要があるかもしれない」と結論しています3。
AIを配ることは教育ではありません。「持っているのに使っていない/使えていない」という実態がある以上、指導医が「どのAIに、何を、どう投げたか」を聞くこと自体に価値があります。これは後述するDEFT-AIの最初のステップそのものです。
3. しかも「AIが間違っているとき」に大きく損をする
入院患者の診断を題材にしたランダム化臨床ビネット調査(hospitalist・NP・PA 計457名)は、AI併用の損得が対称ではないことを示しました4。
| 提示された条件 | ベースライン診断精度73.0%からの変化 |
|---|---|
| 標準的なAIモデルの予測 | +2.9パーセントポイント(95%CI 0.5-5.2) |
| 標準的なAIモデルの予測+説明 | +4.4パーセントポイント(95%CI 2.0-6.9) |
| 系統的に偏ったAIの予測 | −11.3パーセントポイント(95%CI 7.2-15.5) |
| 系統的に偏ったAIの予測+説明 | −9.1パーセントポイント(95%CI 4.9-13.2/偏りありAI単独との差は有意でない) |
ここでの「系統的な偏り」とは、たとえば高齢患者では肺炎の確率を、BMIが高い患者では心不全の確率を過大評価するといった、いかにもありそうな偏りです。原著の結論は「標準的なAIモデルは診断精度を改善するが、系統的に偏ったAIモデルは診断精度を低下させ、画像ベースのAIでよく使われる説明表示はこの有害な効果を緩和しなかった」というものでした4。「AIが根拠を説明してくれるから大丈夫」は成立しません。
さらに、AI補助の恩恵は誰にでも同じように配られるわけではありません。NEJM総説は放射線科医などを対象とした研究を引き、AI補助はベースライン成績が低い臨床家に不釣り合いに害を与えた(disproportionately harmed clinicians with low baseline performance)こと、AIが臨床家を上回る場面では「人+AI」は「AI単独」より悪くなったこと、逆に臨床家がAIを上回る場面でのみ「人+AI」が伸びたことを紹介しています1,5(本記事では原著本文の定性的記述のみを引用し、効果量の数値は扱いません)。
「基礎力を先に作る」という古典的な指導方針は、AI時代に古びるどころか前提条件になります。高い基礎成績のほうが、安全で効果的なAI利用を可能にする側にあるからです。
4. 検証は自動的には起きない ― 正しく評価できたのは中央値56%
では学習者は、AIの誤りに自分で気づけるのでしょうか。最終学年の医学生148名に、GPT-3.5が出した10の臨床シナリオへの回答(うち5つは誤答)の正誤を判定させた調査では、正しく評価できたのは中央値56%でした(曖昧・不正確な理由づけを除外する前は61%)。そしてclinical prompt engineering という概念を知っていたのはわずか5%です6。単一大学・GPT-3.5世代・自己申告を含む調査なので一般化には注意が要りますが、「検証しなさい」と言うだけでは検証は起きないことは示唆されます。
AIは中立な「第二の目」ではない
AIに投げれば認知バイアスが薄まる、という期待も裏切られます。内科外来ビネット9対を用いた強制選択試験では、示唆された誤診(アンカー)を鑑別の1位に置いた割合は、研修医21.2%(17/80)・指導医10.0%(2/20)に対し、LLMは55.6%(40/72)でした(研修医比 オッズ比3.94、95%CI 2.32-7.33、P<0.001/指導医比 オッズ比4.07、95%CI 2.47-7.21、P<0.001)。上位5つにアンカーを含めた割合はLLM 97.2%・研修医67.5%・指導医65.0%です7。実験室設定のビネット研究であり実臨床の頻度として語ることはできませんが、患者や紹介状の一言に、AIは人間以上に引きずられうるということです。
AIが黙ると、人も見なくなる
視線計測を用いたマンモグラフィ読影研究(読影者10名・60例)では、AIが見逃した症例における読影者感度の中央値は、AI併用時39%対AI無し71%(P=.002)まで低下しました。同じ症例で固視の頻度も減っています(0.44対0.47 固視/秒、P=.03)8。読影という設定は臨床推論とは異なるため外挿しすぎてはいけませんが、automation bias が視線のレベルで観測された点は重要です。AIが何も指摘しなければ、人はそこを見なくなります。
5. deskilling は本当に起きるのか ― 大腸内視鏡の実データと、その限界
臨床の実データとして最もよく引かれるのが、ポーランド4施設の大腸内視鏡研究です。非AI下の大腸内視鏡1443件(AI導入前795件/導入後648件)を比較すると、標準(非AI)内視鏡の腺腫検出率(ADR)は28.4%(226/795)から22.4%(145/648)へ低下し、絶対差 −6.0%(95%CI −10.5〜−1.6、p=0.0089)、AI曝露のオッズ比は0.69(95%CI 0.53-0.89)でした9。
より広く見ても、エビデンスはまだ薄いのが実情です。医師の deskilling を扱ったスコーピングレビューは「臨床的な deskilling の証拠は乏しい(scarce)ものの、専門領域を越えて一貫している」「数は限られている(limited in number)ものの、実証研究は一貫して、AIが意図せず医師のパフォーマンスを損ないうること、あるいは技能維持の機会を減らしうることを示している」と述べています11。生成AIの automation bias・deskilling を扱ったシステマティックレビューでも、11,269件をスクリーニングして組み入れられたのは29件で、その多くは観察研究・シミュレーション実験・概念的考察でした14。
つまり「AIで医師が壊れる」と煽る段階ではありません。それでも指導が要るのは、deskilling の証明を待つまでもなく、前章までに見た「渡すだけでは伸びない」「間違ったAIで大きく損をする」「検証は自動的に起きない」がすでに実証されているからです。
6. DEFT-AIアプローチとは ― 頭文字は4文字、ステップは5つ
ここからが本題です。原著のKEY POINTSは、次のように逐語で書いています1。
(DEFT-AI(診断、根拠、フィードバック、教育、そしてAI利用に関する推奨)は、学習者とAIのやり取りの最中に批判的思考とAIリテラシーを促すための構造化された枠組みである)
頭文字はD・E・F・Tの4文字ですが、列挙されている要素は5つです。末尾の「-AI」に対応する5番目が recommendation for AI use(AI利用に関する推奨)——本文の見出しでは AI Engagement Recommendation です。Figure 1 のキャプションでも同じ5要素が並んでいます1。
| 段 | 原著の見出し(逐語) | その段階ですること |
|---|---|---|
| D | Diagnosis, Discussion, and Discourse (KEY POINTSとFigure 1では単に diagnosis) |
指導医はまず学習者自身の臨床推論とAIの使い方を探る。臨床問題の統合(データ収集と帰納的推論)と鑑別診断(演繹的推論と知識量)を尋ね、続けてどのAIツールを使い、どんなプロンプトを打ったか、出力の妥当性を探る追加プロンプトをどう組んだか、その出力が診断アプローチを influenced, replaced, or augmented のどれをしたかを聞く |
| E | Evidence | 支持する根拠と反証する根拠の両方を挙げさせる。診断枠組みの使用、仮説の確証・反証、そして代替仮説を生成する能力(原著は adaptive expertise の証と表現)を評価する。並行してAIリテラシーの自己評価も行わせる |
| F | Feedback | この段階の中心はguided self-reflection(導かれた自己内省)。学習者の自己評価を土台に、見落とした鑑別・知識のギャップ・AI技術リテラシーについて、成長の機会を本人に語らせる |
| T | Teaching | 内省を踏まえて、推論のパフォーマンスとそのAIツールの使い方にフィードバックし、学習者に合わせた一般原則を教える。批判的吟味を含むEBMの原則の適用と、AIリテラシーの促進 |
| AI | AI Engagement Recommendation | 次はどの監督レベルでAIを使ってよいかを言語化して手渡す(次章で詳述) |
なお D は Differential(鑑別)の頭文字ではありません。本文見出しは Diagnosis, Discussion, and Discourse で、KEY POINTS と Figure 1 では diagnosis と略記されています。日本語で紹介する際は両方を併記するのが正確です1。
7. 5番目のステップ「AI Engagement Recommendation」が本体
D・E・F・Tの4段は、後述するようにAI以前から存在した枠組みです。Abdulnour らが足したのは5番目——原著の言葉では次のようになります1。
(指導医は、基礎的技能とAIリテラシーを同時に促す推奨をもって締めくくる。まれな例外を除き、指導医はAIを使い続ける練習を促すべきである)
つまり「AIを使うな」ではありません。示されている結論は実質的に2通りです。
- 間接的または断続的な直接監督のもとで慎重に使ってよい
- 監督なしで安全に使えるが、継続的な自己モニタリングと学習を伴うこと
これは研修医の手技を監督するときの発想——直接監督から間接監督、そして自立へ——とまったく同じです。AI利用を「監督レベル管理の対象となる診療行為のひとつ」として扱うのがDEFT-AIの新しさであり、ここを省略するとDEFT-AIは単なるDEFTに戻ります。日本語の解説では5番目を付記のように扱っているものが少なくないので、指導の最後に一言、監督レベルを声に出して渡すことを習慣にしてください。
8. ステップ別・明日から使える問いかけ集
原著はAIリテラシーの自己評価のための具体的な問いを列挙しています。以下は原文の逐語と日本語です1。
| 分類(原文) | 問いかけ(原文逐語) | 日本語 |
|---|---|---|
| technical understanding | "How do you think the AI reached its conclusions?" | そのAIはどうやってその結論に至ったと思いますか |
| critical appraisal | "What are the weaknesses of this AI? Can you evaluate the capabilities and limitations of the AI application?" | このAIの弱点は何ですか。そのAIアプリケーションの能力と限界を評価できますか |
| practical application | "What problem is the AI you used designed to solve? Does this AI support or impede practice? What are effective prompting strategies?" | あなたが使ったAIは何の問題を解くために作られたものですか。このAIは診療を支えていますか、妨げていますか。効果的なプロンプトの戦略は何ですか |
| エビデンスの提示要求 | "Which peer-reviewed research supports the use of this tool for clinical reasoning support?" | 臨床推論の支援にこのツールを使うことを支持する査読済み研究はどれですか |
さらに原著は、過依存を検出するための具体的な手を1つ挙げています——AIを使わずに、少し変えた症例提示を声に出して推論させることです。原文では "The educator can ask the learner to reason out loud through a modified case presentation without AI in order to assess the learner's ability to explore new problems independently of AI and to identify possible overreliance on AI."1。数分あればでき、しかも過依存の有無がその場で見えます。
E(Evidence)の段階で「AI出力を鵜呑みにしない」ことを具体的に体感させたいときは、実例が効きます。当ブログでは、LLMがてんかん診療でどこまで使えてどこから危ういかを整理した回(てんかん診療における生成AI・LLMの光と影)と、AIに文献確認を任せてはいけない理由を専攻医の病歴要約の実務から書いた回(J-OSLER病歴要約チェッカーを作った話)を公開しています。「実際にこう間違える」を一度見せるほうが、抽象的な注意喚起より効きます。
T(Teaching)で教えるべきこと ― プロンプトの型
原著は "The output is only as good as the input."(出力は入力の質を超えない)として、プロンプトの要素を挙げています1。
- 具体性(specificity):良い例 "What are the most common risk factors for coronary artery disease?"/悪い例 "Tell me about heart disease"
- 文脈の付与(context provision):例 "I'm a pulmonologist caring for a patient in my clinic with asthma that is refractory to inhaler therapy. List several hypotheses to explain the lack of treatment response."
- 誘導プロンプトの害:"What is the diagnosis? I think it is asthma." のようにLLMを誘導するプロンプトは sycophantic(おもねる)応答と、人間と同種の認知バイアスを促しうる
- 例示(few-shot):最初のプロンプトに例となる症例を添えると精度が上がる
- chain-of-thought:「考えを声に出して」と求めるとAIの推論の筋道が見え、出力の精度が上がると同時に推論そのものを評価できる。例:「優先順位をつけた鑑別診断を作って」→「その理由を説明して」
構造化された教育フレームワークとAIを組み合わせる発想自体は、臨床推論に限りません。病状説明のSPIKESをAIと組んだツールを作った回(SPIKES病状説明アシスタントを作った話)も、型を先に決めてからAIに担当範囲を渡すという点でDEFT-AIのT段と同じ発想です。
9. centaur と cyborg ― タスクのリスクで使い分ける
原著はAI利用の行動様式を2つに分けます(KEY POINTSの逐語に基づく)1。
| 行動様式 | 中身 | 推奨される場面(原著) |
|---|---|---|
| centaur(ケンタウロス) | 自分とAIでタスクを分担し、批判的な監督を効かせる。AIは着想・要約・下書きに使い、診断と意思決定は自分の臨床判断に依拠する | 高リスク・不確実・診断的なタスク。とくにそのAIツールの検証済み用途の外(例:汎用チャットボットを複雑な意思決定に使う場合) |
| cyborg(サイボーグ) | タスクの全段階でAIと自分の作業を密に絡み合わせる。反復的にプロンプトし、修正させ、根拠を求めて出力を洗練する | 低リスク・定義が明確・創造的なタスクで、そのAIが信頼できる性能を示している場合(一般的な連絡文の下書き、初期の着想出しなど) |
両者は排他的ではありません("Cyborg and centaur behaviors are not mutually exclusive.")。タスクの複雑さとリスクに応じて2つを行き来できること自体が adaptive practice だと原著は述べます。ただしcyborg的な使い方には "carries the risk of never-skilling, deskilling, or mis-skilling due to automation bias" という但し書きが付きます。そして総括はこうです——"Universally, educators should explicitly caution learners against passively adopting AI output without interrogation."(指導医は例外なく、問いただすことなく受動的にAI出力を採用しないよう、学習者に明示的に注意を促すべきである)1。
10. DEFT-AIは新発明ではない ― Neher 1992 → Savaria 2022 → 2025
この枠組みが導入しやすいのは、まったく新しい型ではないからです。原著は自らの系譜を明示しています1。
- 1992年:One-Minute Preceptor(原著の参考文献55)。5つのmicroskills、すなわち "(1) get a commitment, (2) probe for supporting evidence, (3) teach general rules, (4) reinforce what was done right, and (5) correct mistakes."15
- 2022年:DEFT(原著の参考文献57)。感染症教育の文脈でOne-Minute Preceptorの中核要素を DEFT(Diagnosis, Evidence, Feedback, Teaching) という記述的頭字語に整理したもの。この語は "meaning skillful"(=deft、巧みな)との語呂合わせでもあると原論文の抄録に明記されています。"experiential, adaptable, case-driven, and skills-focused" で他科の臨床教育にも応用可能とされます16
- 2025年:DEFT-AI。DEFTに5番目のステップを足してAI時代へ拡張1
D(コミットさせる)とE(根拠を探らせる)が1992年のOne-Minute Preceptorとそのまま重なることに注目してください。指導医が新しく覚えることは、実質的に5番目だけです。
11. "verify and trust" ― 検証してから信じる
原著の結論部は明快です1。
(検証こそがAI利用の要であるという確信を研修医に植えつける責任は、指導医の側にある)
"Ultimately, fostering a 'verify and trust' paradigm is crucial for ensuring that AI is a beneficial augmentation of human expertise."
(最終的に、「検証してから信じる」というパラダイムを育てることが、AIを人間の専門性の有益な拡張とするうえで決定的である)
よく使われる「まず信じ、そのうえで検証せよ」とは語順が逆である点が肝心です。原著はさらに、AI出力を「完全には追跡できない判断」=leap of faith(信仰の飛躍)を求められる瞬間として定義し、その瞬間を「これはAIとのやり取りだ」と名指しして立ち止まる能力こそがAIリテラシーの出発点だとしています1。
検証の道具は、すでに持っている
では何をもって検証するのか。原著が持ち出すのは新しい技術ではなくSackett の EBM 5ステップです——asking the question, acquiring the best evidence, appraising the evidence, applying the findings to practice, and assessing outcomes(問いを立てる/最良の根拠を得る/根拠を吟味する/結果を診療に適用する/アウトカムを評価する)1,20。
ただし原著は評価対象を2つに分けます。AIツールそのものの評価は査読研究・AIスコアカード・規制情報などに依存し、原著自身が「教育の現場でのリアルタイムの判断には不十分で、現状では指導医にとっての有用性は限定的」「AIツールそのものの包括的な評価は、ほとんどの指導医・学習者の手に余る」と認めています。一方AI出力の評価は臨床家の担当で、ガイドライン・文献・専門医の意見を自力で取得・吟味し、AI出力と突き合わせます。そして重要な一文——AIと人の出力がよく一致することは、人間による警戒の必要性を「減らすことはできても、決して取り除かない(decrease — but never remove —)」1。
運用上のコツとして、独立した2026年の総説は「LLMの有望な教育利用のひとつは、研修医がコミットした後に使う問いかけ補助(question-prompting aids)として、推論を試し深めることかもしれない」と述べています19。これは1992年のOne-Minute Preceptorの "get a commitment" と正確に一致します。順番を守るだけで、同じAIが「答えを配る機械」から「問いを返す相手」に変わります。
12. この枠組みの限界 ― まだ効果は証明されていない
ここまで紹介してきましたが、DEFT-AIの有効性を示す研究は確認できていません。留保は正確に書きます。
- 原典は総説(Review Article)であり、介入研究ではありません1。土台となったDEFTの提唱論文も Perspective で、有効性の検証データは提示されていません16。
- 類縁の学習者中心モデルであるSNAPPSでは、無作為化比較試験5本を集めたシステマティックレビュー・メタ解析が行われていますが、Kirkpatrick Level 3(職場での行動)とLevel 4(患者アウトカム)を報告した研究はゼロでした。低〜中等度の確実性で、症例提示や議論の時間を延ばし、挙げる鑑別の数と不確実性の表明を増やす可能性が示されているにとどまります18。
- deskilling 側のエビデンスも前述のとおり "scarce" です11。
- そして査読後も議論は続いています。原著には3本の書簡が寄せられ、著者らが返答しています(うち1本は慶應義塾大学病院から)21。本記事執筆時点で各書簡の本文を入手できていないため、その主張の内容には踏み込みません。
したがって本記事の立場はこうです——DEFT-AIは「効果が証明された介入」ではなく、「AIとのやり取りをその場で教育機会に変えるための、既存の型の自然な拡張」として使う。使う価値を支えているのは枠組み自体の実証データではなく、前半で見た「渡すだけでは伸びない」「間違ったAIで大きく損をする」「検証は自動的に起きない」という実証データのほうです。
まとめ ― 指導医が明日から変えられる3点
- AIの答えを聞く前に、学習者の答えを先に言わせる
1992年の "get a commitment" そのものです15。コミットした後にAIを使わせると、同じLLMが「答えを配る機械」ではなく「推論を試す相手」になります19。 - 「どのAIに、どんなプロンプトを打ったか」を必ず聞く
DEFT-AIのD段の逐語どおりの問いです1。英国のレプリケーションでは設問の30%しかLLMに投げられていませんでした——学習者は「使いこなしている」とは限りません3。 - 最後に「次はどの監督レベルで使ってよいか」を言葉にして渡す
5番目のステップです。間接的・断続的な直接監督のもとで慎重にか、監督なしで可・ただし自己モニタリングを継続か。ここを省くとDEFT-AIはただのDEFTに戻ります1。
AIの利用を止める必要はありません。原著自身が「まれな例外を除き、指導医はAIを使い続ける練習を促すべきである」と書いています1。止めるのではなく、監督レベルを言語化して渡す——それがAI時代の臨床推論指導の、最も実務的な一歩です。
よくある質問(FAQ)
Q1. DEFT-AIアプローチのステップはいくつありますか?
5つです。原著のKEY POINTSは DEFT-AI (diagnosis, evidence, feedback, teaching, and recommendation for AI use) と逐語で記しています。頭文字はD・E・F・Tの4文字ですが、末尾の「-AI」に対応する5番目のステップ「AI Engagement Recommendation」があり、ここで指導医は「次はどの監督レベルでAIを使ってよいか」を言語化して手渡します1。
Q2. DEFT-AIのDは鑑別診断(Differential)の頭文字ですか?
いいえ。原著本文の見出しは Diagnosis, Discussion, and Discourse であり、KEY POINTSとFigure 1では単に diagnosis と略記されています。この段階では学習者自身の推論を先に語らせ、そのうえでどのAIツールを使い、どんなプロンプトを打ち、その出力が診断アプローチを influenced, replaced, or augmented のどれをしたのかを尋ねます1。
Q3. DEFT-AIはSNAPPSから発展した枠組みですか?
いいえ。原著本文にSNAPPSは一度も登場しません。原著が明示している系譜は、Neher 1992のOne-Minute Preceptor(原著の参考文献55)と、それを頭字語DEFTに整理したSavaria 2022(原著の参考文献57)です15,16。SNAPPSは同じ学習者中心の教育モデルとして比較のために言及できますが、直接の源流ではありません17。
Q4. 研修医が臨床推論にAIを使うことは禁止すべきですか?
原著は禁止を勧めていません。5番目のステップについて "With rare exceptions, the educator should encourage ongoing practice with AI."(まれな例外を除き、指導医はAIを使い続ける練習を促すべきである)と述べています。求められているのは禁止ではなく監督レベルの明示です1。
Q5. DEFT-AIアプローチの有効性は証明されていますか?
証明されていません。原典はNEJMの総説で、土台となったSavaria 2022もPerspectiveです1,16。類縁のSNAPPSでも、無作為化比較試験5本を集めたメタ解析でKirkpatrick Level 3およびLevel 4を報告した研究はゼロでした18。現時点では提唱段階の枠組みとして扱うのが妥当です。
Q6. AIの誤りに研修医が気づけないなら、指導医が毎回AIの出力を確認すべきですか?
すべての出力を指導医が検算することは現実的ではありません。原著が求めているのは検算の代行ではなく、学習者自身に支持する根拠と反証する根拠の両方を挙げさせること(E段)と、AIを使わずに少し変えた症例を声に出して推論させ、過依存の有無をその場で見ることです1。なお、AIと人の出力がよく一致することは人間による警戒の必要性を減らしはしますが、決して取り除かないと原著は明記しています1。
本記事は医療従事者向けの教育・知識整理を目的とした情報提供であり、特定の教育プログラムや診療行為の成果を保証するものではありません。DEFT-AIアプローチは2025年に提唱された枠組みであり、本記事執筆時点でその有効性を検証した研究は確認できていません。引用した研究の多くは観察研究・ビネット研究・総説であり、実臨床への外挿には限界があります。記載は作成時点(2026年8月)の情報に基づきます。
監修:今村久司(京都大学医学部卒・京都大学医学博士/神経内科専門医・指導医/総合内科専門医・指導医)
参考文献
※ [1]〜[21]はいずれもPubMed収載文献。DOI/PMIDを付記し、著者・タイトル・雑誌・年・巻号・ページのメタデータ照合を実施済み。出典: PubMed。
