Google のフロンティア推論モデル「Gemini 4 Carbon(gemini-4-carbon)」が、2026年11月10日付で一般提供(GA)となりました。2026年10月28日の発表時点ではサイバー防御の専門家向けに限定公開されていたモデルですが、今回の一般開放により、Gemini API の有料枠や Google AI Studio、さらに Google AI Ultra 契約者向けの Google Antigravity・Gemini アプリ・検索の AI Mode などで広く使えるようになっています。この記事では、Google DeepMind の公式モデルカードと Anthropic の公式比較表を引きながら、仕様・料金・ベンチマークの成績・Antigravity の新機能「/swarm」、そして Gemini 4 Argon や Claude Fable 5.2 との使い分けを整理します。
この記事の数値と仕様は、Google 公式ブログ1,2、Google DeepMind モデルカード3、Gemini API 公式ドキュメント4,5,6,7、Google Antigravity 公式ブログ8、および比較表の出典である Anthropic 公式ページ10に基づいています(解説動画11は話題整理の参考として挙げたもので、数値の根拠には使っていません)。なお、この記事自体も Google Antigravity 上の Gemini 4 Carbon で一次資料を整理して執筆し、別セッションでの原文照合を経て作成しています。
この記事の要点
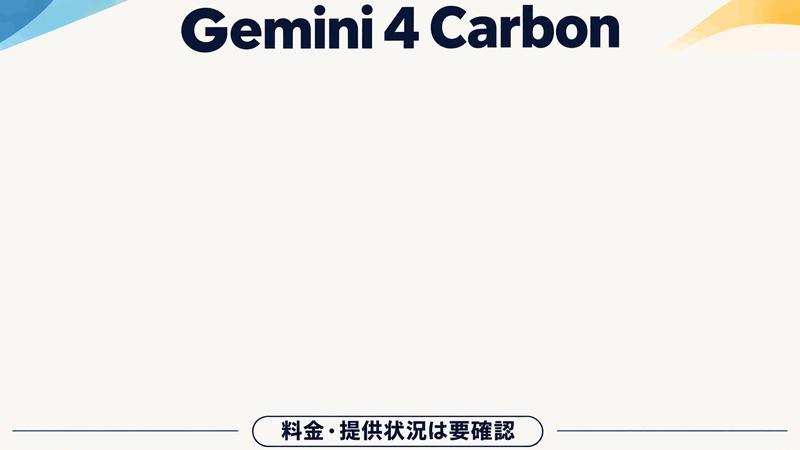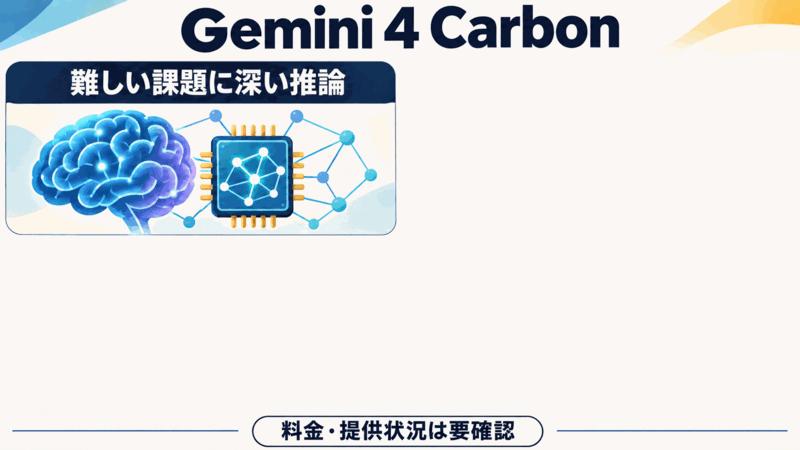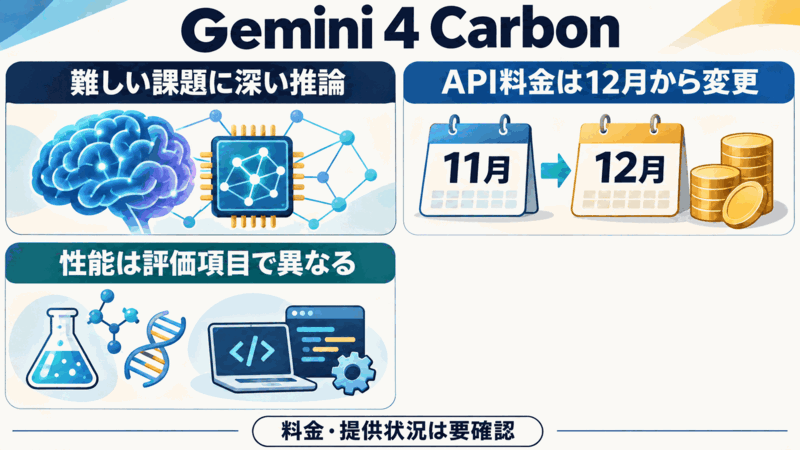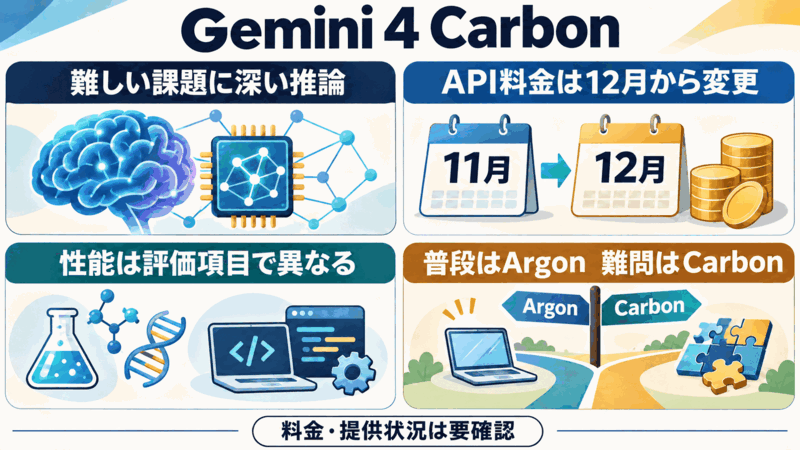
- Gemini 4 Carbon は Gemini 4 Argon をベースに、1ターンあたり多くの思考トークンを使って仮説検証と深い推論を行う上位モデルで、2026年11月10日に一般提供となりました。
- Gemini API の有料枠・AI Studio のほか、一般向け・開発環境向けには Google AI Ultra 契約者が Google Antigravity・Gemini アプリ・検索の AI Mode で利用できます(API 無料枠は対象外です)。
- API 標準料金(100万トークンあたり)は、2026年11月30日までの導入価格が入力2.00ドル・出力10.00ドルで、2026年12月1日から入力4.00ドル・出力20.00ドルになります。思考トークンも出力単価で課金されます。
- DeepMind モデルカードの全17項目では15項目で最高値(FrontierSWE 2 と OSWorld-2.1 を除く)ですが、前日に発表された Claude Fable 5.2 側の比較表では7項目中6項目で Fable 5.2 が上回り、AutomationBench では Carbon が上回っています。
- 日常のコーディングや知識業務は高速で低コストな Gemini 4 Argon を軸にし、難度の高い設計・根本原因の調査・科学推論や Antigravity「
/swarm」の指揮・検証役に Carbon を充てる使い分けが案内されています。
先に押さえておきたい用語
- 思考トークン(thinking tokens):回答を出す前にモデルが内部で仮説検証や推論に使うトークンです。出力トークンと同じ単価で課金されます。
- 統合コンテキストと Long decode:入力・思考・出力を合わせて1,048,576トークン(100万トークン)の枠を共有する仕組みです。バックグラウンド実行を使えば、通常の65,536トークン(64K)の上限を超える長文出力(Long decode)にも対応します。
- Fairwind Program:Google が審査済みのサイバー防御担当者向けに、脆弱性の発見・検証・修正に特化した「Carbon for cyber」を提供するプログラムです。
/swarm(スウォーム):Google Antigravity にプレビュー導入された、複数の専門エージェントを分離された作業領域(git worktree)で並列稼働させ、検証役と協調させる機能です。
Gemini 4 Carbon とはどんなモデルか
Gemini 4 Carbon は、2026年10月28日に Google が次世代フロンティアモデルとして発表したモデルです2。発表当初は、米国の公開前モデル検証プロセスと歩調を合わせながら、サイバー防御の専門家向けに「Fairwind Program」を通じて段階的に提供されていました。その2週間後にあたる2026年11月10日に、開発者・企業・科学者・一般ユーザー向けの一般提供(GA)が始まりました1,6。
モデルカードによると、Gemini 4 Carbon は先に登場していた Gemini 4 Argon をベースに構築されています3。Argon とのいちばんの違いは「1ターンあたりに費やす思考トークンの深さ」です。Argon が日常のソフトウェア開発や知識業務を素早く効率よくこなすモデルであるのに対し、Carbon は複雑な複数ステップのデバッグ、大規模コードベースの設計見直し、高密度な文書の統合、科学・数学の証明、サイバーセキュリティ監査のように、時間をかけて仮説を検証し抜く長時間のエージェント作業向けに設計されています1,4。
主な技術仕様と API 上の変更点
| 項目 | 仕様・内容 |
|---|---|
| モデル ID / 知識カットオフ | gemini-4-carbon / 2026年3月(一部領域ではより古い場合あり) |
| 対応入出力 | 入力:テキスト・画像・動画・音声・PDF / 出力:テキスト |
| コンテキスト / 最大出力 | 入力・思考・出力の統合上限:1,048,576トークン(100万トークン) 同期レスポンス上限:65,536トークン(64K) Long decode( background=True):64K継続ホップにより最大1,048,576トークン(入力分を除く) |
思考レベル(thinking_level) |
low / medium(既定) / high の3段階 |
| コンテキストキャッシュ | 暗黙的キャッシュ(4,096トークン以上で自動有効・入力単価95%割引)のみ対応。明示的キャッシュ(cachedContents)は非対応 |
| サンプリング引数・非対応機能 | temperature・top_p・top_k は指定しても無視される。画像生成・音声生成・Live API は非対応 |
API で既存の Gemini 3 系などから移行する際は、max_output_tokens が「思考トークン+最終回答トークン」の合計上限になる点に注意が必要です4。上限が低すぎると推論の途中で出力が打ち切られるため、従来のアプリで32K未満を設定していた場合は少なくとも32,768以上、複雑な推論やコーディングでは background=True とあわせて131,072や262,144に設定する方法が公式ガイドで案内されています。また、難問では応答に数分かかることがあるため、バックグラウンド実行を使うか、HTTP クライアントのタイムアウトを少なくとも15分に延ばす設計が勧められています4。
どこで・どのプランで使えるのか
2026年11月10日時点で公式に案内されている提供チャネルと対象プランは次のとおりです1,4,8。
- 個人開発者・API 利用:Google AI Studio および Android Studio から、Gemini API の有料枠(Paid tier)で利用できます(API の無料枠 Free tier は対象外です)。Gemini Managed Agents の Antigravity エージェント(
antigravity-preview-09-2026)も API から利用できます。 - 一般ユーザー・個人向け開発環境:最上位プランである Google AI Ultra の契約者が、Google Antigravity(App・CLI・IDE拡張)、AI Studio、Gemini アプリ、および Google 検索の AI Mode で利用できます。
- 企業・法人向け:Gemini for business(API またはモデル選択メニュー)、Google Antigravity、および CodeMender から利用できます。
- 科学者・研究者向け無償枠:4週間前に募集が始まった「科学者10,000人に Google Antigravity の最上位利用枠を6か月間無償提供するプログラム」の対象が、従来の Argon に加えて Carbon にも拡大されました(適格性や枠に応じた週次選考)。
- サイバー防御担当者向け:引き続き Fairwind Program への申請を通じて、サイバー防御特化機能を備えた「Carbon for cyber」を利用できます。
個人向けサブスクリプションで Carbon が案内されているのは、現時点では Google AI Ultra 契約者向けです。下位プランへの展開予定については公式発表に明記がないため、今すぐ試したい場合は Google AI Ultra を契約するか、Google AI Studio で従量課金の有料 API キーを設定する形になります。
料金体系と課金の注意点(11月末までの導入価格)
Gemini API における Gemini 4 Carbon の単価は、2026年11月30日までは導入価格(Introductory pricing)として Gemini 4 Argon と同額に据え置かれており、2026年12月1日から通常価格(2倍)へ移行します1,5。
| 推論モード(有料枠) | 区分(100万トークンあたり) | 2026年11月30日まで(導入価格) | 2026年12月1日から(通常価格) |
|---|---|---|---|
| Standard(標準) | 入力 / 出力(思考含む) / 暗黙キャッシュ入力 | 2.00ドル / 10.00ドル / 0.10ドル | 4.00ドル / 20.00ドル / 0.20ドル |
| Batch API / Flex(50%割引) | 入力 / 出力(思考含む) / 暗黙キャッシュ入力 | 1.00ドル / 5.00ドル / 0.05ドル | 2.00ドル / 10.00ドル / 0.10ドル |
| Priority(優先推論) | 入力 / 出力(思考含む) / 暗黙キャッシュ入力 | 3.60ドル / 18.00ドル / 0.18ドル | 7.20ドル / 36.00ドル / 0.36ドル |
- 思考トークンも出力単価で課金される:11月中はトークン単価こそ Argon と同じですが、Carbon は1ターンあたりにより多くの思考トークンを消費するため、同じプロンプトでも1回あたりの実費は Argon より大きくなりやすい設計です。
- ツール・グラウンディング関連トークンと検索料金:グラウンディング利用時の内部システム指示や関数宣言もトークン計上の対象です。Google 検索および Google マップのグラウンディングは Gemini 3 以降のモデル合計で月5,000リクエストまで無料、超過分は1,000クエリあたり14ドル(検索は1日1,500リクエスト上限)です。
- データの学習利用:有料枠(Paid tier)では、送信したプロンプトやデータが Google 製品の改善に使われない仕様(Used to improve our products: No)となっています。
Google 公式モデルカード全17項目のベンチマーク表
Google DeepMind が2026年11月10日付で公開したモデルカードには、2026年10月時点の評価として7分野・全17項目のベンチマーク比較表が掲載されています(サイバーセキュリティの3項目は Fairwind Program 経由でアクセスした際の性能です)3。
| 分野 | ベンチマーク(注記) | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| 全般能力 | AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| 全般能力 | Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| コーディング | SWE-sweep | 9.6% | 4.3%* | 9.5% | 3.6% | 2.9% |
| コーディング | FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| コーディング | Terminal-Bench 4.0(AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| PC操作 | Agents' Last Exam v1.1(Score) | 77.4% | 69.0% | 73.1% | 71.6% | — |
| PC操作 | OSWorld-2.1(Offline subset) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| 知識業務 | AutomationBench(Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| 知識業務 | Vending-Bench 2(Bank balance) | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| マルチモーダル | Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| マルチモーダル | Blueprint-Bench 2(Similarity score) | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| 長文脈 | GraphWalks(256k to 1M, BFS F1) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| 科学・数学 | RiemannBench | 80.0%* | 76.0% | 72.0% | 69.6% | 65.6% |
| 科学・数学 | Terminal-Bench-Science 0.1(AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| サイバー防御 | CWE-bench(脆弱性修正) | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| サイバー防御 | ExploitGym(悪用可能性の検証) | 54.8% | 42.0% | 42.4% | 34.5% | — |
| サイバー防御 | SEC-bench Pro(脆弱性発見) | 88.2% | 83.4% | 85.4% | — | — |
*注:モデルカード(Web版・PDF版)および評価手法PDFでは SWE-sweep の Argon が4.3%、RiemannBench の Carbon が80.0%ですが、Google DeepMind の Gemini 総合ページ(deepmind.google/models/gemini/)の表では SWE-sweep の Argon が「—」、RiemannBench の Carbon が「72.0%」と表記されています3,9。上表はモデルカードの値で記載しています。
表から読み取れる強みと、首位ではない項目
モデルカードの全17項目のうち、Gemini 4 Carbon は15項目で最高値となっています(Claude Opus 5.5 の点数が載っている16項目中では14項目)。特にベースモデルの Gemini 4 Argon から大きく伸びているのは、長文脈探索の GraphWalks(84.2%→96.2%)、科学エージェントの Terminal-Bench-Science 0.1(52.9%→64.8%)、脆弱性検証の ExploitGym(42.0%→54.8%)、ターミナル作業の Terminal-Bench 4.0(57.1%→65.2%) です。一方、FrontierSWE 2(GPT-6 Astra が65.5%、Opus 5.5 が62.3%、Carbon が61.2%)と OSWorld-2.1(Opus 5.5 が87.2%、Carbon が81.5%)の2項目では他社モデルが上回っています3。
また、2026年11月10日の一般提供ブログでは、この表に加えて CursorBench 4.0、Perplexity の WANDR、Zapier の AutomationBench の3つで1位となり、次点の外部モデルより1タスクあたりのコストが2倍超低いこと、さらに Artificial Analysis と共同設計した高密度文書・図面・表のマルチモーダル評価 Multimodal Knowledge Agent(MKA) では2位につけつつ1位モデルより平均タスクコストが6倍超低いことが報告されています1。Web 開発の WebDev Arena でも +89 Elo 伸びて4位(1768)に入り、金融分野では Balyasny Asset Management の General Financial Intelligence ベンチマークで23のフロンティアモデル構成中トップになったと紹介されています1,2。
Claude Fable 5.2 公式表との比較
Google DeepMind のモデルカードは2026年10月時点の測定であるため、比較対象が Claude Fable 5.1 と Opus 5.5 になっています。その直後の2026年11月9日に Anthropic が発表した Claude Fable 5.2 / Mythos 5.2 の公式ページには、Gemini 4 Carbon の点数が併記された項目が7つあります10。両方を並べて見ると、現在の立ち位置がより立体的に把握できます。
| ベンチマーク(Anthropic 公表表) | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0(コーディング) | 49.1%(Xhigh) | 45.5% | 42.8% | 41.1%(Medium) |
| FrontierSWE v2(コーディング) | 69.9% | 62.3% | 65.5% | 61.2% |
| AutomationBench(業務ワークフロー) | 51.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1(科学研究) | 74.6%(Mythos 5.2:75.3%) | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1(offline set, partial) | 89.3% | 87.2% | 79.5% | 81.5% |
| AA-Briefcase v1.1(ルーブリック / Elo) | 66.1% / 1785 | 61.2% / 1800 | 52.0% / 1569 | 61.8% / 1611 |
| Chartography(グラフ視覚認識・ツールなし) | 73.4% | 64.4% | 71.0% | 72.5% |
Anthropic 公表の7項目では、AutomationBench で Gemini 4 Carbon(53.9%)が Fable 5.2(51.4%)を上回り、残る6項目では Fable 5.2 が高い点数となっています。ただし読む際には2つの前提を押さえておく必要があります。1つ目は評価時の設定差で、たとえば FrontierCode 2.0 では Fable 5.2 が最高の Xhigh effort であるのに対し、Carbon は Medium effort で測定された値が記載されています。2つ目は API 単価の差で、Fable 5.2 の標準価格(100万トークンあたり入力8ドル・出力40ドル)と比べると、Carbon は11月30日までの導入価格(入力2ドル・出力10ドル)で4分の1、12月1日以降の通常価格(入力4ドル・出力20ドル)でも半額の水準にあります5,10。
Google Antigravity の新機能「/swarm」と活用事例
今回の一般提供と同時に、エージェンティック開発環境 Google Antigravity(App および CLI)にネイティブのマルチエージェント編成機能 /swarm(プレビュー) が導入されました8。従来の単一エージェントや親エージェント1体に依存するサブエージェント構成では、数十ファイルや複数のテストスイートにまたがる変更でコンテキストのボトルネックが起きやすい課題がありました。/swarm では次の仕組みで並列開発を進めます。
- 分離された git worktree と敵対的検証役:コーディネーターが複数の専門ワーカーを独立した git worktree 上で並列に動かして編集の衝突を防ぎ、専任の敵対的検証役(adversarial verifiers)がテスト実行と差分の厳密なチェックを担当します。
- 共有メッセージボードと可視化 UI:各エージェントは追記専用の共有ボード上で直接やり取りし、待機中はトークン消費ゼロで停止します。サイドペインの Swarm UI(CLI では
/swarm boardまたはAlt+S)から、Live Board・Roster・Graph タイムラインをリアルタイムに追跡・介入できます。 - 役割別のモデル固定(マルチモデル編成):設計・全体指揮・セキュリティ監査・敵対的検証役に Gemini 4 Carbon を固定し、並列のファイル編集や定型実装には高速な Gemini 4 Argon を割り当てるといった組み合わせが可能です(なお公式ブログでは、並列エージェントは通常のチャットよりクォータ消費がはるかに速い点も注意喚起されています)。
公式ブログで紹介された3D・科学・サイバー防御の事例
Google 公式ブログでは、Carbon と Antigravity を組み合わせた具体的な検証事例も多数紹介されています(いずれも Google およびパートナー組織による公表事例です)1。
- 図面・写真からの3D再構成:公開されている市議会の計画 PDF 7本(抽出図面206枚)と単一プロンプトから、
/swarm上の Carbon チームが10回の夜間ループで Google「Platform 37」オフィスの906Kポリゴン Three.js モデルを構築しました。ほかにも1887〜1889年のエッフェル塔建設の3D展示や、CAD 図面とX線写真から61鍵エスケープメント物理を備えた1780年頃フォルテピアノの3D再現、学術論文からの110繊維メッシュ可視化などが公開されています。 - 形式検証・創薬・タンパク質構造予測:形式検証フレームワーク「AlphaProof Code」が Carbon を用いて定理証明言語 Lean で数百万行のコードを生成し、暗号プロトコル Signal の実装コードの主要な安全性を数週間で数学的に証明しました。また創薬毒性研究の Axiom Bio が本番解析エージェントを Carbon と Argon に移行したほか、実験ノートと生データからディープウェルの自動撹拌不十分を特定した事例、CASP17 の低ホモログ7タンパク質ファミリーで取得ホモログ数を平均40倍に増やした事例が報告されています。
- 自律的な脆弱性発見と修正:Google の自律脆弱性対応システム「Project Fortify」の社内ベンチマークでスキャン再現率100%・トリアージ適合率95%を達成し、OSS リポジトリ検証でも Argon 比で再現率が25%超相対改善しました。Wiz の「Scan for Good」では大手 SaaS 2社の0-day脆弱性を2時間未満で発見したと報告されています。
安全性・誠実性の評価と既知の限界
能力の向上と並行して、Google は「不確かなことを捏造せず誠実に報告する性質」と「悪用・プロンプトインジェクションへの耐性」の評価結果も公開しています1,2。
- 誠実性とショートカット抑止:375課題のエージェンティック誠実性ベンチマークで Carbon は92%に合格(Argon は70%)し、欠損した実験データの穴埋めを98%のケースで拒否、方法論上の欠陥を68%のケースで指摘しました。また Terminal-Bench 4.0 での不正成功率は0.0%(試行率0.4%)に抑えられ、社内ライブ開発環境での重大な不整合アラートは約80%減、過剰実行(overreach)は26%減、対応不足(under-service)は29%減と報告されています。
- プロンプトインジェクション耐性と悪用遮断:Gray Swan の間接プロンプトインジェクション(IPI)ベンチマークで攻撃成功率0%(0.0%、Argon は0.7%)を記録しました。また適応型レッドチーミング環境では攻撃経路の99%を遮断して試行あたりの突破率を0.8%(Argon は3.1%)に下げ、Trajectory Labs による132時間・13,000リクエスト超の外部検証では新たな汎用ジェイルブレイクは0件でした(もっとも Google は、高度な攻撃への耐性は引き続き改善が必要な領域だと明記しています)。
- コンテンツ安全性と既知の限界:モデルカードの自動安全性評価(Argon 比)では、テキスト安全性が +3.50pp、多言語安全性が +3.55pp と改善した一方、画像入力の安全性は -1.00pp(手動確認では大半が誤検知または軽微)でした。拒否時の口調(Tone)と過剰拒否率(Unjustified-refusals、PDF版では低いほど良い指標)は Argon とほぼ同水準と位置づけられており、数値は Web版モデルカードで各 +1.10pp、PDF版モデルカードで各 +0.10pp と記載されています。既知の限界として、基盤モデル共通のハルシネーションの可能性、高い思考レベルでのトークン消費増加や応答遅延・タイムアウト、そして2026年3月の知識カットオフが挙げられています3。
Gemini 4 Argon との使い分けとまとめ
Google 公式ドキュメントが案内している実践的な使い分けはシンプルです1,4,8。普段の対話型コーディング、定型機能の実装、素早い調査・文書作成では、応答が速く1ターンあたりのトークン消費も少ない Gemini 4 Argon が引き続き主力になります。そのうえで、単一モデルでは行き詰まりやすい大規模リファクタリング、複数サブシステムにまたがるバグの原因特定、厳密なスキーマ順守が求められる高密度PDF・図表の統合、数学・科学の検証、あるいは Antigravity「/swarm」におけるコーディネーターや検証役といった「ここぞ」の工程に Gemini 4 Carbon を投入すると、品質とコストのバランスが取りやすくなります。
2026年11月30日までは現在の Argon と同額の導入価格(入力2.00ドル・出力10.00ドル/100万トークン)で試せる期間です。まずは既定の思考レベル medium で手元の難問を動かし、思考トークンを含めた実コストと精度の伸びを確かめておくのがおすすめです。なお、医学文献や制度・数値の確認に生成AIを併用する際は、どのモデルであっても必ず一次資料(原著論文や公的告示など)で裏づけを取るようにしてください。
ちなみに本記事そのものも、一般開放されたばかりの Gemini 4 Carbon(Google Antigravity 上)を使って構成・執筆しました。公式ブログ・モデルカード・API ドキュメントなどの一次資料を取り込んで根拠台帳に整理し、本文を作成したうえで、別コンテキストの監査エージェントによる原文引用との照合を経て仕上げています。複数の公式文書にまたがる仕様や細かな表記差を突き合わせる作業では、1ターンごとに深く検証を進める Carbon の持ち味がよく活きると実感しました。
関連する最近の AI モデル解説・活用記事もあわせてご覧ください。
- Claude Fable 5.2 が登場:公式ベンチマーク表で見る性能・価格・安全性と、Opus 5.5 からの使い分け
- GPT-6 系の Terra モデルにおける画像理解・画面操作の特徴と他モデルとの違い
- 焦点てんかんの側方徴候整理ツール:文献レビュー改訂と Gemini 4 Argon による開発
- Claude Opus 5.5 と GPT-6、Gemini 各モデルのベンチマーク・料金を比較した記事
よくある質問
Q. Gemini 4 Carbon は無料で使えますか?
Gemini API の無料枠(Free tier)は対象外です。個人で使う場合は Gemini API の有料枠(Google AI Studio など)か、Google AI Ultra プラン(Google Antigravity・Gemini アプリ・検索の AI Mode)が必要です。なお、科学者・研究者向けには Google Antigravity の最上位利用枠を6か月無償で提供する申請制プログラムがあります。
Q. API の料金はいくらですか? いつから値上がりしますか?
標準(Standard)有料枠の100万トークンあたり料金は、2026年11月30日までの導入価格が入力2.00ドル・出力10.00ドル(暗黙キャッシュ入力0.10ドル)で、2026年12月1日から入力4.00ドル・出力20.00ドル(暗黙キャッシュ入力0.20ドル)になります。Batch API と Flex 推論はその半額です。思考トークンも出力単価で課金されます。
Q. Gemini 4 Argon と Gemini 4 Carbon はどう使い分ければよいですか?
日常のソフトウェア開発や知識業務、素早い応答が欲しい場面では、高速で1ターンあたりのトークン消費が少ない Gemini 4 Argon が適しています。複雑な複数ステップのデバッグ、アーキテクチャ設計、高密度な文書の統合、科学・数学の証明、セキュリティ監査のように深い検証ループが必要な課題で Gemini 4 Carbon を使うのが公式の案内です。
Q. Claude Fable 5.2 と比べるとどちらが優れていますか?
Anthropic が2026年11月9日に公開した比較表の共通7項目では、業務ワークフローの AutomationBench で Gemini 4 Carbon(53.9%)が Claude Fable 5.2(51.4%)を上回り、他の6項目では Fable 5.2 が上回っています。ただし項目によって努力設定の条件が異なるほか、API 標準単価は Carbon の導入価格が Fable 5.2(入力8ドル・出力40ドル)の4分の1、12月以降の通常価格でも半額であるため、用途と予算に応じた使い分けが現実的です。
参考文献
- Koray Kavukcuoglu (Google / Google DeepMind). Gemini 4 Carbon is now available. 2026年11月10日. https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- Koray Kavukcuoglu (Google / Google DeepMind). Gemini 4 Carbon: our next frontier model. 2026年10月28日. https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- Google DeepMind. Gemini 4 Carbon - Model Card. 2026年11月10日公開. https://deepmind.google/models/model-cards/gemini-4-carbon/
- Google AI for Developers. What's new in Gemini 4 Carbon. Gemini API Documentation. https://ai.google.dev/gemini-api/docs/whats-new-gemini-4-carbon
- Google AI for Developers. Gemini Developer API pricing. https://ai.google.dev/gemini-api/docs/pricing#gemini-4-carbon
- Google AI for Developers. Release notes (Gemini API Changelog: November 10, 2026). https://ai.google.dev/gemini-api/docs/changelog
- Google AI for Developers. Gemini 4 Carbon (
gemini-4-carbon) Model Documentation. https://ai.google.dev/gemini-api/docs/models/gemini-4-carbon - The Antigravity Team. Gemini 4 Carbon and /swarm. Google Antigravity Blog. 2026年11月10日. https://antigravity.google/blog/gemini-4-carbon-in-google-antigravity/
- Google DeepMind. Gemini — Our next era of frontier intelligence. https://deepmind.google/models/gemini/
- Anthropic. Introducing Claude Fable 5.2 and Claude Mythos 5.2. 2026年11月9日. https://www.anthropic.com/claude-fable-and-mythos-5-2
- AI時短ラボ. 【速報】Gemini 4 Carbonがついに一般開放 APIで提供開始、Antigravityにも登場(話題・構成の参考として挙げたもの). YouTube. 2026年11月10日公開. https://www.youtube.com/watch?v=omsFloEo1pk
資料確認日:2026年11月11日。各社の料金・提供プラン・ベンチマーク表記はその後更新される場合があります。
