「ChatGPTに症状を入れたら、てんかんを診断してくれるのでは?」——患者さんからも、医療者からも、そんな声を聞くようになりました。生成AI・大規模言語モデル(LLM)は、てんかん診療のどこで使えて、どこで危険なのでしょうか。本記事は、てんかん×AIシリーズ深掘り第5回として、患者教育・情報抽出・診断支援の「光」と、自律診断の限界・参考文献の捏造(hallucination)という「影」を、PubMedで実在確認した一次文献の数字とともに、脳神経内科医の視点で線引きします。
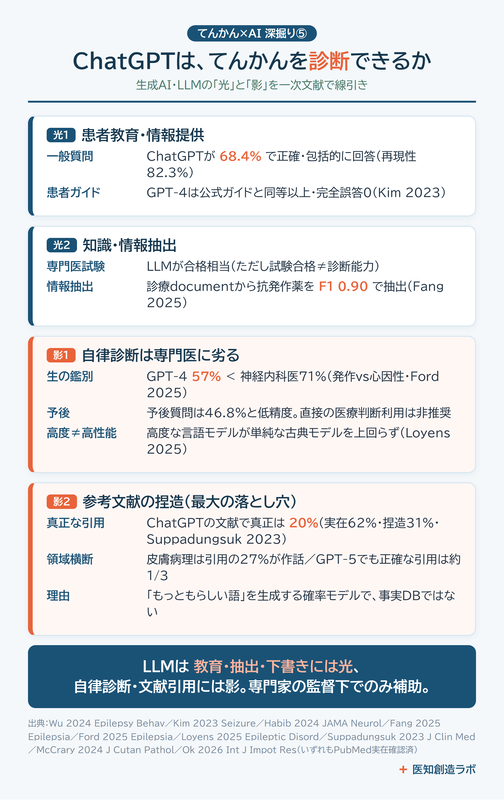
結論を先に言えば、「教育・下書き・情報抽出には光、自律診断と文献引用には影。LLMは専門家の監督下でのみ補助になる」。ChatGPTはてんかんの一般質問の68.4%に正確・包括的に回答する一方、患者の語りからの生の診断は専門医に劣り、生成する参考文献の多くは捏造です。光と影の両方を、誇張せず整理します。
監修:今村久司(脳神経内科専門医)
▼ 解説動画(約7分半・ナレーション+字幕つき)
📊 スライドだけ見る(スライドビューア・全17枚/PDF可)
目次
- そもそもLLMとは何か
- 光①:患者教育・情報提供
- 光②:専門知識・試験
- 光③:情報抽出・研究支援
- 影①:自律診断は専門医に劣る
- 影②:最新・高度モデル=高性能ではない
- 影③:参考文献の捏造という最大の落とし穴
- なぜ捏造するのか
- 正しい使い方(専門知識で補強)
- よくある質問(FAQ)
※本記事はてんかん診療×AIシリーズ深掘り第5回です。あわせて総説回:てんかん診療×AIの全体像、第2回:AIによる脳波の自動判読、第3回:発作検出ウェアラブルと発作予測もご覧ください。
そもそもLLMとは何か
大規模言語モデル(LLM)は、膨大な文章から「次に来そうな言葉」を確率的に選ぶことで、自然な文を生成するモデルです。ChatGPTもこの仕組みで動いています。ここが、光と影の両方を理解する出発点になります。LLMは事実を引くデータベースではなく、「もっともらしさ」を生成する道具です。だからこそ、人間らしい説明が得意である一方、存在しない情報を堂々と出力する性質を併せ持ちます。
光①:患者教育・情報提供
まず明確な「光」が、患者教育です。国際抗てんかん連盟などから集めた378問をてんかん専門医が評価した研究では、ChatGPTは68.4%の質問に「正確かつ包括的」に回答し、82.3%の質問で再現性のある回答を返しました1。感情的サポートを求める質問にも、自然で理解しやすい応答が可能でした。
別の研究では、韓国てんかん学会の患者ガイドに基づく57問で、GPT-4の回答の多くが「十分な教育的価値」を持ち、完全な誤答はゼロ。しばしば公式ガイドと同等以上でした2。つまり、患者さんへの説明文の下書きや、よくある質問への一次対応には、すでに実用域にあります。
ただし注意も必要です。前者の研究では予後に関する質問で包括的だった回答は46.8%にとどまり、著者は「医療ガイダンスとしての直接利用は推奨しない。現時点の主用途は患者教育」と明記しています1。誤った答えを鵜呑みにすれば、危険な助言になりえます。
光②:専門知識・試験
知識の面でも、LLMは高い能力を示します。LLMをてんかん専門医の模擬試験(board exam)で評価した研究では、合格に相当する成績を出しました3。知識の想起というタスクは、LLMの得意分野です。
ただし、ここは慎重に解釈すべきです。試験に合格すること=目の前の患者を臨床で診断できること、ではありません。知識を持つことと、不確実な情報の中で判断を下すことは、別の能力だからです。
光③:情報抽出・研究支援
三つ目の光が、非構造化テキストからの情報抽出です。King's College Hospitalの280件の診療レターを用いた研究では、オープンソースLLM(Llama)が、てんかん型をF1=0.80、発作型をF1=0.76、そして現行の抗発作薬(ASM)をF1=0.90で抽出し、従来手法を上回りました4。電子カルテからの構造化に、LLMが力を発揮します。
研究支援も同様です。抗発作薬cenobamateの模擬RCTで、4種類の医師筆致で書かれたノイズの多いカルテからデータを統合させたところ、AIの解析は人間の解析と3%未満の差で薬効や症状を同定しました5。重要なのは、これらが「診断」ではなく「情報の抽出・整理」だという点です。ここはLLMの明確な光です。
影①:自律診断は専門医に劣る
ここからは「影」です。最も重要な限界が、自律的な診断です。患者の症状記述だけから、てんかん発作と心因性(機能性/解離性)発作を鑑別させたGPT-4の研究では、ゼロショットでの正答率(balanced accuracy)は57%。経験ある神経内科医の71%に届きませんでした6。
| 患者の語りからの鑑別 | 正答率(balanced accuracy) |
| GPT-4(ゼロショット) | 57% |
| GPT-4(1例提示) | 64%(2・3例提示でも頭打ち) |
| 経験ある神経内科医 | 71% |
1例を与えると64%まで改善しましたが、2例・3例を与えても頭打ちでした。一方、3名の神経内科医が全員正答した「易しい」18例では、GPT-4も81%に達しています6。プロンプトの工夫や追加情報で潜在能力を引き出せる可能性は示唆されますが、生の診断では、現時点でLLMは専門医に劣るのが実情です。
影②:最新・高度モデル=高性能ではない
もう一つ、よくある誤解が「最新で高度なモデルなら、必ず性能も上がる」というものです。これは必ずしも正しくありません。1561件の初診患者レターから小児てんかんを早期診断する研究では、BERTベースの高度な文埋め込みモデル(精度0.74)が、計算的に単純な古典的モデル(Naïve Bayes・精度0.73)を上回りませんでした7。課題によっては、「新しい=賢い」ではないのです。
影③:参考文献の捏造という最大の落とし穴
そして、LLM最大の落とし穴が参考文献の捏造(reference hallucination)です。腎臓病領域でChatGPTが挙げた610件の参考文献を検証した研究では、実在したのは62%のみ、31%が完全な捏造、真正(authentic)だったのはわずか20%でした。リンクは68%が誤り、DOIは54%が不正確でした8。
| 検証(領域) | 引用・文献の問題 |
| 腎臓病 | 真正な引用は20%(実在62%・捏造31%) |
| 皮膚病理 | 引用の27%が作話、臨床的に有用なのは24.5% |
| GPT-5のレビュー | 正確な引用は約3分の1のみ(本文の事実精度は比較的高い) |
これは一領域だけの問題ではありません。皮膚病理の免疫染色推奨を検証した研究では、引用の27.2%が作話で、臨床的に有用な引用は24.5%にとどまりました9。最新のGPT-5でさえ、外科レビューで正確な引用は約3分の1で、捏造・不完全な書誌情報が複数見られました10。興味深いことに、本文の事実そのものは比較的正確です。つまり「文章は正しそうでも、出典は捏造」——これが共通のパターンです11。
なぜ捏造するのか
理由は、LLMの仕組みそのものにあります。LLMは存在する文献を検索しているのではなく、「それらしい著者名・誌名・年」を確率的に生成しているからです。だから、実在しない引用が、もっともらしい形で堂々と出力されます。
対策は明確です。引用は必ず一次資料(PubMedなど)で実在を確認すること。LLMに出典を生成させて、それを鵜呑みにしないこと。これは、医療コンテンツを扱うすべての人にとって必須の運用です(本記事の参考文献も、すべてPubMedで著者・誌名・巻号まで照合しています)。
朗報:検索接地(Deep Research・RAG)なら捏造はほぼ消える
ただし、ここまでは「LLMに出典を生成させた場合」の話です。近年は検索接地(retrieval-grounded)——いわゆるDeep ResearchやRAG(Retrieval-Augmented Generation)——という、実在する文献データベースを検索して引用させる使い方が広がり、捏造は劇的に減っています。PubMed APIに接地した多エージェント系では引用の実在率が99.8%に達し、Perplexity(Sonar)もほぼ100%でした13。別の比較研究でも、従来型のChatGPT(GPT-4o)が参考文献の82%を捏造したのに対し、RAG型のツール(OpenEvidence・ScholarQA)は捏造0%で正答率80%を達成しています14。
ここで重要なのは、効いているのが「検索接地」であって「最新・高性能モデルだから」ではない点です。同じ比較研究では、新しい生成モデルほど捏造率はむしろ上昇し、捏造された引用の89%が2023〜2025年の(一見新しそうな)文献でした14。課金版が役立つのは、Deep Researchやブラウジングという「検索接地の手段」が使えるからであって、モデルの賢さそのものが捏造を消すわけではありません。
とはいえ、接地すれば完璧、ではありません。引用が実在しても、本文との対応がずれたり、解釈を誤ったりする誤りは残ります13。だからこそ、検索接地で下書きを作り、最後は一次資料(PubMedなど)で実在と内容を確認する——この二段構えが、現時点での現実的なベストプラクティスです。
正しい使い方(専門知識で補強)
では、どう活かすべきか。鍵は専門知識による補強です。汎用のChatGPT単独ではなく、専門家の知識基盤(オントロジー)とEEG情報を組み合わせたカスタムGPTでは、薬剤抵抗性てんかんの発作局在の推定精度が93.8%まで向上しました12。汎用モデル単独の性能とは別物であり、「専門家が監督し、構造化された知識で補強する」ことが価値を生みます。
結論として、LLMは専門家の監督下で使う「下書き・たたき台」です。単独の判断者ではなく、人が必ず検証する前提の補助ツール——この線引きが、安全な活用の第一歩になります。
まとめ
生成AI・LLMは、てんかん診療において、患者教育(68.4%が正確・包括的)・情報抽出(抗発作薬をF1 0.90で抽出)・研究の下書きには明確な光があります。一方で、患者の語りからの生の診断は専門医に劣り(57%<71%)、生成する参考文献はしばしば捏造(真正20%)という影があります。だからこそ原則は、「人が必ず検証する前提で、専門家の監督下でのみ補助として使う」こと。賢い助手であっても、最終的に判断するのは人です。
次回は「てんかん外科×AIと、薬剤反応の予測」を深掘りします。▶ 関連:脳神経内科の鑑別診断ツール一覧を見る
よくある質問(FAQ)
Q1. ChatGPTにてんかんの症状を入れたら、診断してもらえますか?
自律的な診断は推奨されません。患者の語りからてんかん発作と心因性発作を鑑別させた研究で、GPT-4の正答率は57%と、神経内科医の71%に届きませんでした。診断は必ず専門医が行うべきです。
Q2. では、LLMは何に使えますか?
患者教育(一般質問の68.4%に正確・包括的に回答)、説明文の下書き、診療documentからの情報抽出(抗発作薬をF1 0.90で抽出)など、「情報の整理・提示」に光があります。診断や治療の最終判断には使わないのが原則です。
Q3. ChatGPTが示した参考文献は信頼できますか?
出典を生成させた場合は信頼できません。ある検証では、ChatGPTが挙げた文献のうち真正だったのは20%のみ、31%が完全な捏造でした。最新のGPT-5でも正確な引用は約3分の1です。一方、Deep ResearchやRAG(検索接地)で実在文献を検索させると実在率はほぼ100%まで改善します。ただし接地しても本文との対応ズレは残るため、引用は必ずPubMedなどで実在と内容を確認してください。
Q4. なぜLLMは存在しない文献を作るのですか?
LLMは文献を検索しているのではなく、「それらしい著者名・誌名・年」を確率的に生成しているからです。事実データベースではなく「もっともらしさ」を生成する道具であるため、実在しない引用が堂々と出力されます。
Q5. 最新の高性能モデルを使えば問題は解決しますか?
必ずしも解決しません。小児てんかんの診断では、高度な言語モデルが単純な古典的モデルを上回りませんでした。引用の捏造もGPT-5で残っています。モデルの新しさだけでは限界を越えられません。
Q6. 医療現場でLLMを安全に使うコツは?
専門家の監督下で「下書き・たたき台」として使い、出力は必ず人が検証することです。専門知識(オントロジー)やEEGなどで補強したカスタム運用では局在推定が93.8%まで向上した例もあり、補強と検証が鍵です。
参考文献
- Wu Y, et al. Evaluating the performance of the language model ChatGPT in responding to common questions of people with epilepsy. Epilepsy Behav 2024;151:109645. PMID 38244419. DOI
- Kim HW, et al. Assessing the performance of ChatGPT's responses to questions related to epilepsy. Seizure 2023;114:1-8. PMID 38007922. DOI
- Habib S, et al. Large Language Model Performance on Practice Epilepsy Board Examinations. JAMA Neurol 2024;81(6):660-661. PMID 38587850. DOI
- Fang S, et al. Extracting epilepsy-related information from unstructured clinic letters using large language models. Epilepsia 2025;66(9):3369-3384. PMID 40637590. DOI
- Goldenholz DM, et al. Inductive reasoning with large language models: A simulated randomized controlled trial for epilepsy. Epilepsy Res 2025;211:107532. PMID 40020525. DOI
- Ford J, et al. Can artificial intelligence diagnose seizures based on patients' descriptions? A study of GPT-4. Epilepsia 2025;66(6):1959-1974. PMID 40013839. DOI
- Loyens J, et al. AI language model applications for early diagnosis of childhood epilepsy based on unstructured first-visit patient narratives. Epileptic Disord 2025;27(6):1263-1274. PMID 41042619. DOI
- Suppadungsuk S, et al. Examining the Validity of ChatGPT in Identifying Relevant Nephrology Literature. J Clin Med 2023;12(17):5550. PMID 37685617. DOI
- McCrary MR, et al. Evaluating the diagnostic performance of a large language model-powered chatbot for immunohistochemistry recommendations in dermatopathology. J Cutan Pathol 2024;51(9):689-695. PMID 38744501. DOI
- Ok F, et al. Evaluation of ChatGPT-5-generated surgical literature: the accuracy of a review on penile prosthesis implantation. Int J Impot Res 2026. PMID 42203918. DOI
- Jain A, et al. Citation integrity in the age of AI: evaluating the risks of reference hallucination. J Craniomaxillofac Surg 2025;53(10):1871-1872. PMID 40830000. DOI
- Chiang KL, et al. Customized GPT model largely increases surgery decision accuracy for pharmaco-resistant epilepsy. J Clin Neurosci 2024;130:110918. PMID 39541652. DOI
- Gorenshtein A, et al. LITERAS: Biomedical literature review and citation retrieval agents. Comput Biol Med 2025;192(Pt B):110363. PMID 40383055. DOI
- Hooshiar MH. Artificial intelligence reliability in implant dentistry: a comparative analysis of clinical accuracy and hallucination patterns across multiple language models. J Prosthet Dent 2026;135(5):e155-e161. PMID 41266194. DOI
