日本時間の2026年11月18日未明、OpenAIがGPT-6.2 AstraとGPT-6.2 Solを発表しました。Astraは複数の資料を読み込んで成果物まで仕上げるような仕事に、Solは日々の文章作成やコード修正に向けたモデルです。両方ともChatGPT Work、Codex、APIに登場しました。1
今回の発表で目を引くのは、難しい課題をこなす力が上がり、課題1件あたりの費用も下がった点です。たとえば専門業務の評価では、6.2 Astraは旧Astraより高い得点を約3分の1の費用で記録しました。一方、実際のコードベースを使う評価では、6.2 Solが6.2 Astraに近い得点を約5分の1の費用で出しています。
制作メモ:この記事の原稿作成と公式資料の照合に、CodexのGPT-6.2 Solを使いました。
動画で見る GPT-6.2 AstraとSol
旧モデルや他社モデルとの比較
最初に見たいのが、OpenAIの発表に掲載されたArtificial Analysis Intelligence Index v5.0.1の費用・性能グラフです。知識、推論、コーディング、科学研究などを含む9つの評価をまとめた指標で、横軸は費用、縦軸は総合スコアです。同じ得点なら左側、同じ費用なら上側にあるほうが有利です。一つのモデルに点が複数あるのは、推論強度を変えて測定しているためです。

| モデル | 推論強度 | 得点 | 課題あたり |
|---|---|---|---|
| GPT-6.2 Astra | Max | 62.1 | $4.00 |
| GPT-6 Astra | Max | 56.9 | $6.24 |
| GPT-6.2 Sol | Max | 57.3 | $1.01 |
| GPT-6.1 Sol | Max | 54.6 | $1.27 |
| Claude Fable 5.2 | Max | 64.6 | $26.54 |
| Gemini 4 Carbon | High | 60.0 | $7.76 |
| Claude Opus 5.5 | Max | 59.1 | $10.04 |
掲載された点のなかで最高スコアはClaude Fable 5.2の64.6です。6.2 Astraは62.1で、費用はFable 5.2の約15%。得点が近い点を選んで比べても、Fable 5.2(Xhigh)は62.2で$14.83、6.2 Astra(Max)は62.1で$4.00でした。Gemini 4 Carbon(High)の60.0に対しては約半分の費用で上回りました。さらに6.2 Solは、旧Astra(Max)の56.9に対して57.3を記録し、費用は約6分の1でした。なお、このグラフで旧Astraは「GPT-6 Astra」と表記され、GPT-6.1 Astraの系列は掲載されていません。
専門業務と科学研究でのAstra
Agents’ Last Exam v1.1は、複数工程を含む専門業務を遂行する能力の評価です。6.2 AstraはXhighで78.3%、約$2.89。図中の旧Astraの最高点(Max)は73.1%、約$8.99、Fable 5.2の最高点(Max)は72.8%、約$60.05でした。各モデルの図中最高点を比べると、6.2 Astraは旧Astraより約5.2ポイント、Fable 5.2より約5.5ポイント高くなっています。このときの6.2 Astraの費用はFable 5.2の約5%です。Gemini 4 Carbon(High)は77.4%、約$4.60でした。Fable 5.2の結果では、代替モデルを使った9課題が除外されています。

科学研究の手順をターミナルで遂行するTerminal-Bench-Science 0.1では、Max同士で6.2 Astraが77.1%、旧Astraが68.1%。費用はそれぞれ$7.15と$23.80でした。第三者モデルの点は、使用するツールや実行環境でも変わります。たとえば図中のFable 5.2はmini-swe-agentを使った評価で、OpenAIの脚注ではAnthropicがClaude Codeで報告したMaxの74.6%も紹介されています。

生物学の実データを解析し、シミュレーション内で仕組みを推定するVals Science Index v1でも、Maxの6.2 Astraは68.4%、旧Astraは65.1%でした。科学研究という同じ括りでも、図3と図4では課題の内容が異なります。

Humanity’s Last Examの改訂版ではどうか
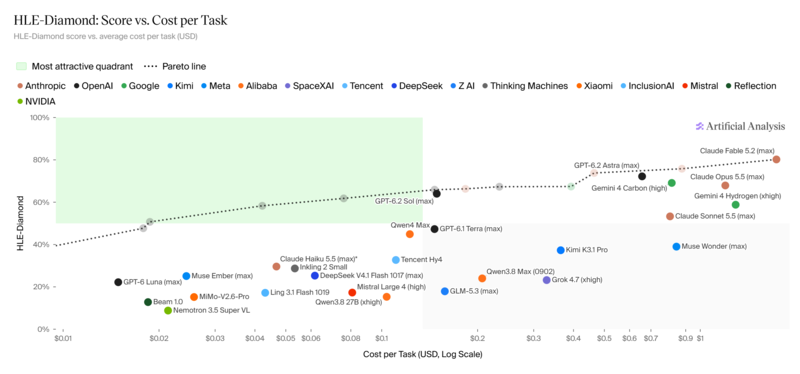
図1の総合指標に含まれるHLE-Diamondは、Humanity’s Last Examを見直して作った1,000問の評価です。評価元のArtificial Analysisによると、推論問題に限った得点は、GPT-6.2 AstraのMaxが84.8%、Claude Fable 5.2のMaxが85.6%(既定の代替モデル設定あり)でした。2下のグラフは、推論と知識を含むHLE-Diamond全体の得点と課題あたりの費用を示しています。
SolはどこまでAstraに迫ったか
既存のコードを直す用途で参考になるのがFrontierCode 2.0です。実際のコードベースを使い、変更を保守担当者が取り込める水準に仕上げられるかを評価します。Max同士では6.2 Solが43.8%、$1.29、6.2 Astraが44.2%、$5.97。この条件で、SolはAstraに近い得点を約5分の1の費用で出しました。図中のFable 5.2はXhighで49.1%に達しており、精度を最優先する場合と、費用を抑えながら繰り返し使う場合とでは、見たい点が変わります。

住まい探しなど、条件に合わせて提案をまとめるLifeValでも、Maxの6.2 Solは83.8%、$1.27。旧Astra(Max)の79.8%、$9.04を上回り、費用は約7分の1でした。

使える場所とAPI料金
ChatGPTではWork、Codexではアプリのモデル選択欄またはCLIの /model から選択できます。Enterprise/Eduでは管理者による有効化が必要です。利用対象のプランと高速モードの詳細は、ChatGPT Learnの提供案内に掲載されています。3
| モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
発表時点の標準単価では、6.2 Astraの入力・出力は旧Astraより20%下がり、6.2 Solは6.1 Solと同額です。発表時点では、Claude Fable 5.2の標準の入力・出力単価もAstraと同じ$8・$40でした。4それでも図1の課題あたりの費用には差があります。課題を終えるまでに使うトークンの量や推論強度、キャッシュの扱いによって、費用は変わります。長い入力や高速モードの扱いは、AstraとSolのAPI仕様を確認してください。
実務での使い分け
日常的な原稿の整理、定型レポート、既存コードの修正なら、まず6.2 Solを試すのがよさそうです。資料をまたいだ照合や、体裁までそろえる必要があるスライド、複数の変更をまとめて実装・検証する仕事では、6.2 Astraを試す価値があります。
上のグラフは発表時点の評価結果です。自分の仕事で選ぶなら、同じ依頼と資料を両モデルに渡し、そのまま使えるか、手直しに何分かかったかまで見比べると、モデルの差が判断しやすくなります。
関連記事:GPT-6 Astra・Claude Fable 5.1・Gemini 3.8 Flash Highの比較、Codexを使ったブログサイト改修の実例。
よくある質問(FAQ)
GPT-6.2 AstraとSolはどこで使えますか?
ChatGPTではWorkで使えます。Codexではアプリのモデル選択欄やCLIのモデル選択から利用できます。APIのモデルIDは gpt-6.2-astra と gpt-6.2-sol です。
GPT-6.2 AstraはClaude Fable 5.2より高得点ですか?
評価によって異なります。OpenAIの発表図では、Agents’ Last Examでは6.2 Astraの図中最高点が上回り、Artificial Analysisの総合指標ではFable 5.2のMaxが上回りました。
グラフのドル表示は月額料金ですか?
評価の課題1件あたりの費用です。ChatGPTの月額料金や、APIの100万トークンあたりの単価とは別の数字です。
参考資料
- OpenAI. Introducing GPT-6.2 Astra and Sol(米国日付2026年11月17日)。
- Artificial Analysis. HLE-Diamond Benchmark、GPT-6.2 Astraのモデル評価。
- OpenAI. GPT-6.2(ChatGPT Learn)。
- Anthropic. Claude Fable 5.2のAPI仕様と料金。
参考動画:AI時短ラボのGPT-6.2速報(3分06秒付近から)。標準のトークン単価と実際の評価費用を対比した解説です。
